
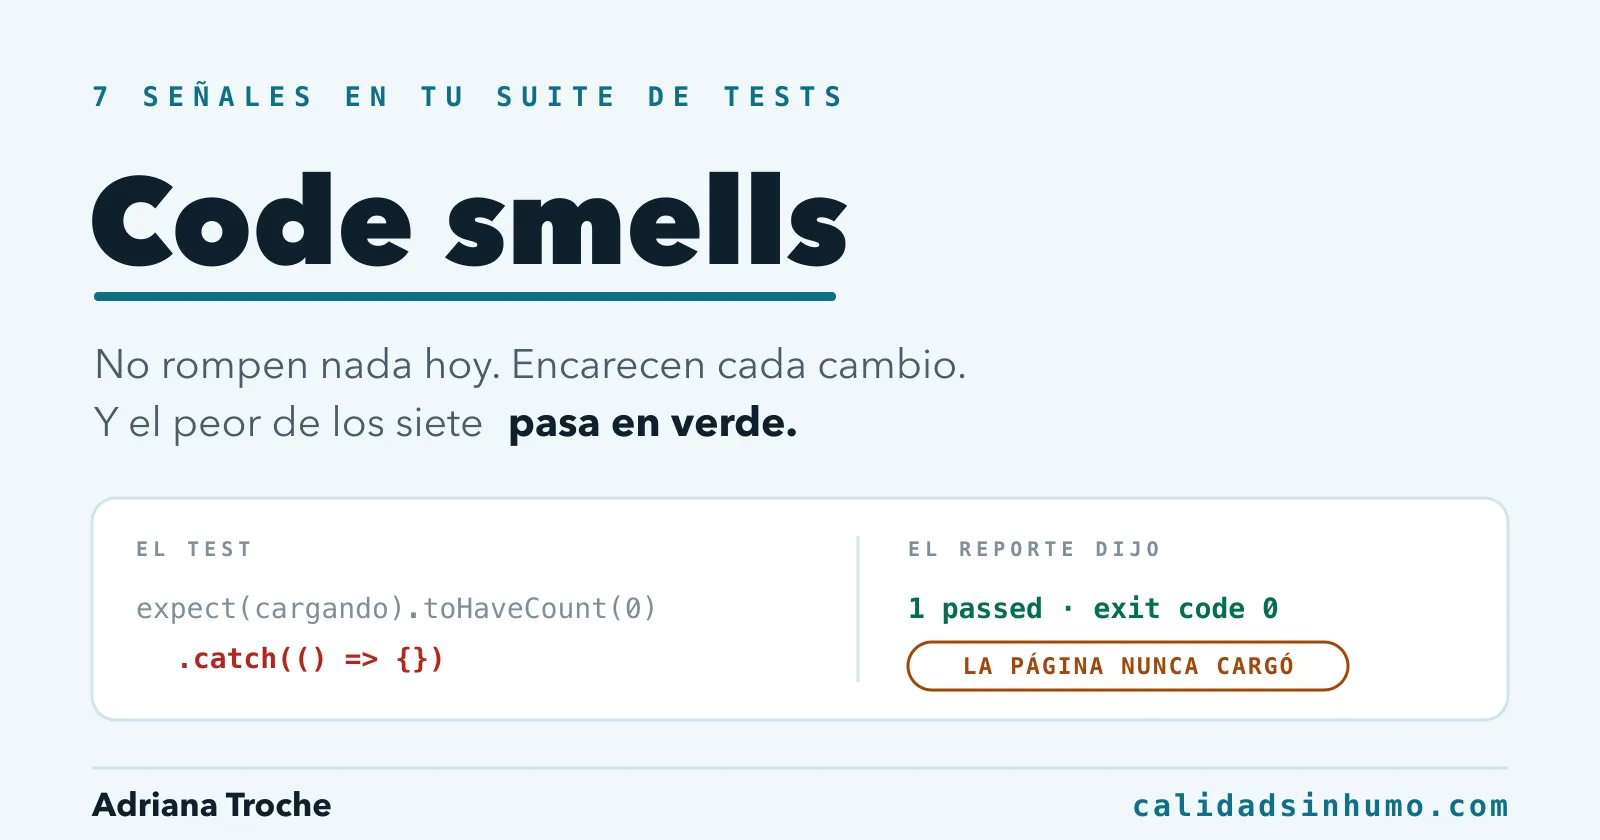
En la suite de Academia sin Humo hay un test que hace esto:
await expect(page.getByTestId("cuenta-hydrating")).toHaveCount(0, { timeout: 5000 }) .catch(() => { // El testid no existe si hydrating ya terminó — continuar });Primero, qué es eso de hydrating. Cuando abres una página de la academia, primero llega la pantalla dibujada, pero los botones todavía no responden. Uno o dos segundos después se carga la parte que la hace funcionar: el menú, la sesión, los clics. Eso se llama hidratación, y mientras dura, la página muestra un elemento oculto, cuenta-hydrating, que funciona como un cartel de «todavía estoy cargando». El test espera hasta cinco segundos a que ese cartel desaparezca antes de comprobar nada.
El comentario dice que el .catch() está ahí por si el cartel no existe, porque la carga ya terminó. Pero si el cartel no existe, toHaveCount(0) ya pasa solo, sin ayuda. El único caso en el que el .catch() hace algo es el contrario: cuando la página se queda cargando para siempre. Ahí la aserción falla, el .catch() se traga el error y el test sigue como si nada.
La suite está en verde. Ese test también. Y sigue ahí hoy.
No es un bug: no rompe nada. Es un code smell, una señal en el código de que algo va a costar caro más adelante. Y es de los que más me importan, porque su trabajo es esconder justo el fallo que el test tendría que mostrar.
Esta es la segunda pieza de la línea sobre code smells en suites de automatización. La primera fue una conversación en LinkedIn: una suite puede estar verde y ser inmantenible. En agosto audité esta misma suite con una rúbrica de siete criterios y me dio 15 sobre 21; esa rúbrica mide si tus tests protegen hoy. Esta pieza mide otra cosa: cuánto te va a costar cambiarlos mañana.
Qué es un code smell en una suite de tests (y por qué no es un bug)
Un bug hace que algo funcione mal. Un code smell no hace que nada funcione mal: hace que cada cambio cueste más, y que el día que algo falle sea más difícil enterarse o entender por qué.
En una suite de tests eso se traduce en tres costos concretos:
- Falsos fallos. Tests que se ponen en rojo sin que haya un bug, y el equipo aprende a ignorarlos.
- Falsos verdes. Tests que pasan aunque el producto esté roto. Es el más caro, porque nadie lo ve.
- Retrabajo. Un cambio de una línea en la aplicación que obliga a tocar veinte archivos de tests.
Por eso el código de una suite puede estar en verde y ser deuda técnica al mismo tiempo. El verde dice que hoy no falló nada. No dice cuánto cuesta mantenerlo así.
Para escribir esta pieza busqué las siete señales de la lista en dos suites que mantengo: la de Academia sin Humo (160 tests, mi proyecto) y una suite de API de mi trabajo (217 tests). Encontré tres. Cada señal va con lo que encontré, aunque sea un cero, porque un cero también enseña algo.
Smell 1: tests que dependen del orden de ejecución
Qué es. Un test que solo pasa si antes corrió otro. El primero crea un dato, el segundo lo usa.
test.describe.serial("pedidos", () => {  let pedidoId: string;
  test("crea un pedido", async ({ request }) => {    const r = await request.post("/api/pedidos", { data: { items: 2 } });    pedidoId = (await r.json()).id;  });
  test("cancela el pedido", async ({ request }) => {    // Si el test anterior falla o no corre, este falla por otra razón    const r = await request.delete(`/api/pedidos/${pedidoId}`);    expect(r.status()).toBe(204);  });});
Cómo reconocerlo. Busca serial y variables declaradas fuera de los tests que algún test modifica:
rg -n "describe\.serial|mode: .serial" testsrg -n "workers: 1|fullyParallel: false" playwright.config.tsLa segunda línea importa más de lo que parece. Una suite configurada con un solo worker nunca te va a mostrar que sus tests dependen del orden, porque siempre corren en el mismo. Para comprobarlo, córrela una vez en paralelo:
npx playwright test --fully-parallel --workers=4Si aparecen fallos que nunca habías visto, ahí están.
Qué riesgo trae. Cuando falla el primer test, fallan todos los que dependen de él, y el reporte te muestra cinco rojos donde hay un solo problema. Además, no puedes correr un test suelto para investigarlo.
Lo que encontré. En Academia, cero: cada test crea su propio usuario. En la suite de API, un bloque serial, y está justificado: comparte un archivo pesado de solo lectura para no descargarlo dos veces. Pero esa suite corre con workers: 1, así que el cero de dependencias no está probado. Está sin probar.
Smell 2: esperas fijas para resolver la sincronización
Qué es. Un waitForTimeout o un sleep puesto porque el test fallaba a veces y con dos segundos de espera dejó de fallar.
// Con espera fija: dos segundos siempre, alcancen o noawait page.click("#guardar");await page.waitForTimeout(2000);expect(await page.textContent(".toast")).toBe("Guardado");
// Con espera por una condición: termina apenas aparece el mensajeawait page.getByRole("button", { name: "Guardar" }).click();await expect(page.getByText("Guardado")).toBeVisible();
Cómo reconocerlo.
rg -n "waitForTimeout|setTimeout|sleep\(" testsOjo con lo que devuelve: test.setTimeout(120_000) también aparece, y no es una espera fija. Es el tiempo máximo que se le da a un test. Ese resultado se descarta.
Qué riesgo trae. Dos, y van en direcciones opuestas. Si la aplicación tarda más que la espera, el test falla sin que haya un bug. Si tarda menos, el test pierde tiempo en cada corrida. Diez esperas de dos segundos en una suite que corre en cada push son minutos de pipeline que el equipo paga todos los días.
Lo que encontré. Cero en las dos. La aserción de Playwright ya espera sola hasta que la condición se cumple, y eso hace innecesaria casi cualquier espera fija. Si vienes de Selenium, este es el hábito que más cuesta dejar. Lo cuento en detalle en flaky tests en Playwright.
Smell 3: el mismo selector copiado en decenas de archivos
Qué es. El mismo localizador escrito a mano en muchos lugares, en vez de vivir en un solo sitio.
Este sí lo encontré, en mi suite. Las cuatro líneas que registran una alumna están copiadas seis veces en tres archivos:
await page.getByTestId("cuenta-registro-name").fill("Alumna Test");await page.getByTestId("cuenta-registro-email").fill(email);await page.getByTestId("cuenta-registro-password").fill("Segura2026!");await page.getByTestId("cuenta-registro-submit").click();El botón de continuar del paso a paso, step-continuar, aparece 26 veces. Y la función que genera emails únicos está copiada en cinco archivos distintos.
Cómo reconocerlo. Este comando cuenta cuántas veces aparece cada selector y te muestra los más repetidos:
rg -o --no-filename 'getByTestId\("[^"]+"\)' tests | sort | uniq -c | sort -rn | headSi usas locator() o getByRole(), cambia el patrón del comando por esos.
Qué riesgo trae. El día que el formulario de registro cambie un campo, hay que encontrar y corregir seis copias. Si se te escapa una, ese test falla, alguien pierde una tarde investigando, y el bug no estaba en el producto sino en la copia que nadie actualizó.
Lo que corresponde es que el registro viva en un solo lugar, una función compartida o una fixture, y que los tests la llamen. Cómo hacer ese refactor sin frenar la entrega va en una pieza propia de esta línea.
Smell 4: el Page Object gigante (o el archivo de tests gigante)
Qué es. Una clase que empezó representando una página y terminó con cuarenta métodos de seis pantallas distintas. Todo el mundo la toca, y cada cambio rompe algo que no tenía nada que ver.
Cómo reconocerlo. Ordena tus archivos por cantidad de líneas (si tus Page Objects viven en otra carpeta, agrégala después de tests):
fd -e ts . tests | xargs wc -l | sort -n | tailCualquier archivo que pase de 300 o 400 líneas merece una mirada. No porque el número sea malo en sí, sino porque casi siempre esconde varias responsabilidades juntas.
Qué riesgo trae. Cada cambio en la aplicación termina tocando el mismo archivo, y dos personas que trabajan en flujos distintos se pisan.
Lo que encontré. La versión al revés. Academia no tiene Page Objects: los helpers viven adentro de los tests. Y por eso uno de mis archivos de tests tiene 1.038 líneas, con seis funciones de apoyo adentro. Es el mismo problema con otra forma: todo junto, en un solo lugar que crece.
Smell 5: un test que valida demasiadas cosas
Qué es. Un test que entra, se registra, compra, cambia la contraseña, sale y verifica todo eso en un solo flujo. Cuando falla, el nombre del test no te dice qué se rompió.
Cómo reconocerlo. Cuenta las aserciones por archivo y abre los de arriba:
rg -c "expect\(" -g "*.spec.ts" tests | sort -t: -k2 -n | tailPero ojo con el número. El test con más aserciones de mi suite tiene doce, y no es un smell: las doce comprueban el mismo comportamiento, que el kit de recursos se lea sin descargarlo. Lo que delata el smell no es la cantidad de expect, sino que validen cosas que no tienen nada que ver entre sí. La pregunta para cada test es una sola: ¿puedo describir en una frase qué comportamiento protege?
Qué riesgo trae. Si una aserción del medio falla, las de abajo nunca corren, y no sabes si esas partes funcionan. Y el diagnóstico tarda más, porque hay que leer todo el flujo para entender qué falló.
Lo que encontré. Nada en ninguna de las dos. El máximo en la suite de API es de cinco aserciones.
Smell 6: datos compartidos entre pruebas
Qué es. Varios tests que usan el mismo usuario, el mismo registro o la misma cuenta, y dependen de que nadie lo toque.
Cómo reconocerlo. Busca cuentas y registros escritos a mano:
rg -n "@ejemplo\.com|@test\.com|process\.env\.[A-Z_]*(USER|EMAIL|ID)" testsQué riesgo trae. Un test contamina al siguiente, o un cambio de datos que nadie del equipo hizo rompe la suite.
Lo que encontré. Este es el que encontré en la suite de API. Quince archivos dependen de registros de prueba que viven en producción. Un día alguien borró uno, y dos tests empezaron a fallar con un error 400 antes de llegar a comprobar los permisos que tenían que probar. El fallo no tenía nada que ver con los permisos: el test se había quedado sin el dato que necesitaba para empezar. Hoy esos dos están marcados como pendientes, con el motivo escrito, hasta que se recapture el dato.
La suite tiene una defensa para esto, y vale copiarla: una función que comprueba que el registro existe y, si desapareció, falla con un mensaje que lo dice. Sin ella, el síntoma apunta a un bug de permisos que no existe.
En Academia, en cambio, hay una sola cuenta compartida, que solo se usa para iniciar sesión y nunca se modifica. Ese riesgo es bajo.
Smell 7: errores atrapados para mantener el pipeline en verde
Qué es. Un try/catch o un .catch() que se traga el fallo, un test.skip() sin motivo o una aserción que se debilitó «para que pase». Es el smell del principio de esta pieza.
Cómo reconocerlo.
rg -n '\.catch\((async )?\(\) => \{|\.catch\(\(\) => (null|false|undefined)\)|test\.(skip|fixme)\(\)|expect\.soft' testsNo todo lo que sale es un smell. Un .catch() que registra el error y lo vuelve a lanzar está bien. Uno que convierte el error en un false y después hay una aserción que lo comprueba, también. El problema es el que deja que el test siga como si nada.
En mi suite, además del que abre esta pieza, hay otros dos iguales y cuatro más que se tragan la navegación después de registrarse:
await page.waitForURL("**/", { timeout: 10000 }).catch(() => {});Si el registro falla, el test no se entera ahí. Se entera tres líneas después, con un error de inscripción que no dice nada del registro. Y hay cuatro test.skip() sin texto que expliquen por qué: el motivo está en un comentario del código, pero en el reporte no aparece.
Qué riesgo trae. Es el único de los siete que produce falsos verdes. Los otros encarecen la suite; este la hace mentir. Un test que se traga su propio fallo deja pasar el bug que tenía que frenar, y el reporte dice que todo está bien.
La suite de API, en cambio, salió limpia: cada .catch() registra el error, lo vuelve a lanzar o lo convierte en un fallo más claro, y cada skip tiene su motivo escrito.
Lo que encontré en mis dos suites
| Smell | Academia sin Humo | Suite de API del trabajo |
|---|---|---|
| 1. Dependencia del orden | No | Uno justificado (sin probar) |
| 2. Esperas fijas | No | No |
| 3. Selectores duplicados | Sí | Leve |
| 4. Archivo gigante | Sí, el archivo de tests | No |
| 5. Tests que validan demasiado | No | No |
| 6. Datos compartidos | Leve | Sí |
| 7. Errores atrapados | Sí | No |
En agosto, mi suite sacó 15 sobre 21 en una rúbrica que mide si los tests protegen, y aun así tenía un .catch() que puede hacer que uno no proteja nada. La rúbrica pregunta si cada test sabe qué es correcto; esta revisión pregunta si el código de la suite deja que ese test lo diga. Hacen falta las dos.
Qué arreglar primero: por riesgo, no por lo feo que se ve
Con la lista en la mano, la tentación es empezar por lo más visible: el archivo de mil líneas, las copias del registro. Es lo que más molesta al leer el código. No es lo que más riesgo tiene.
El orden que uso es por consecuencia:
- Errores atrapados (smell 7). Primero, siempre. Es el único que deja pasar bugs a producción con la suite en verde.
- Datos compartidos (smell 6) y dependencia del orden (smell 1). Producen falsos fallos, y un equipo que ve rojos falsos aprende a ignorar los verdaderos.
- Esperas fijas (smell 2). Cuestan tiempo de pipeline en cada corrida y generan fallos intermitentes.
- Selectores duplicados, archivos gigantes y tests que validan demasiado (smells 3, 4 y 5). Encarecen cada cambio, pero no esconden bugs. Se arreglan de a poco, cada vez que un ticket te obliga a tocar esa parte.
En mi caso, eso significa que antes de mover una sola línea del archivo de 1.038, saco los siete .catch() que se tragan errores. Son minutos de trabajo y es lo único de mi lista que puede estar mintiendo.
Cómo llevar esto a quien decide en qué se invierte
A la persona que decide en qué se invierten las horas del sprint, «la suite tiene code smells» no le dice nada. Le suena a estética.
Lo que sí le dice algo es el riesgo, con número:
Revisé la suite buscando 7 señales de deuda técnica. Encontré [N].
La urgente: [X] tests atrapan sus propios errores, así quepueden pasar en verde con el flujo de [FLUJO] roto.Arreglarlo lleva [horas] y no frena ninguna entrega.
El resto ([lista corta]) encarece cada cambio, pero no escondebugs. Propongo corregirlo de a poco: cada ticket que toque esaparte deja su sección limpia antes de agregar tests nuevos.
Tres párrafos: qué encontraste, qué es urgente y por qué, y un plan que no pide frenar la entrega.
Lo que te llevas
Corre los siete comandos de esta pieza sobre tu suite. Son diez minutos. No todo lo que salga va a ser un smell, y eso es parte del ejercicio: para cada resultado, la pregunta es si ese código puede hacer que un test pase con el producto roto, o que falle con el producto sano.
Si encuentras un .catch() que se traga una aserción, empieza por ahí. Y si tu suite corre con un solo worker, córrela una vez en paralelo antes de dar por buena cualquier conclusión sobre el orden.
En la próxima pieza de esta línea: code smell, bug y deuda técnica no son lo mismo, y por qué un smell puede pasar años sin producir un solo fallo.